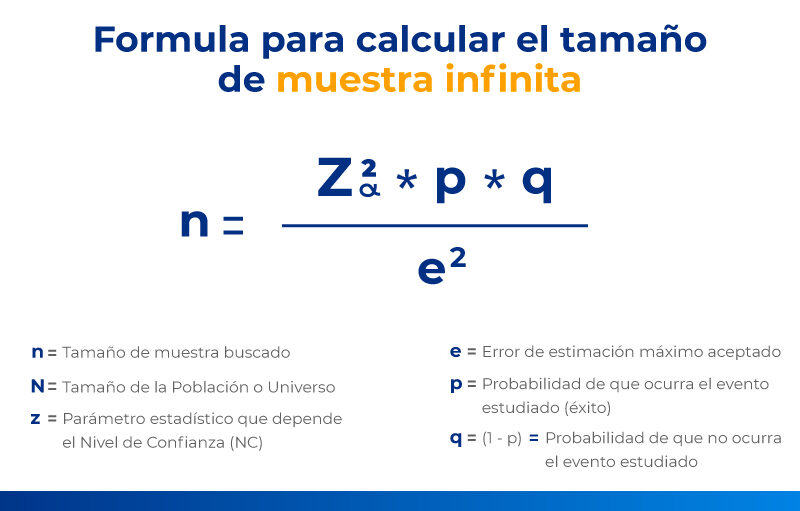
Un diseño de muestra es un plan definitivo para obtener una muestra de una población determinada. Se refiere a la técnica o al procedimiento que el investigador adoptaría al seleccionar elementos para la muestra. El diseño de la muestra también conduce a un procedimiento para indicar el número de elementos que se incluirán en la muestra, es decir, el tamaño de la muestra. Por lo tanto, el diseño de la muestra se determina antes de la recopilación de datos. Entre varios tipos de técnica de diseño de muestra, el investigador debe elegir las muestras que son confiables y apropiadas para su estudio de investigación.
Hay varios pasos que el investigador debe seguir. Esos son;
- Tipo de universo: en el primer paso, el investigador debe aclarar y debe ser experto en el estudio del universo. El universo puede ser finito (no se conocen los artículos) o infinitos (no se conocen números de elementos).
- Unidad de muestreo: se debe tomar una decisión sobre una unidad de muestreo antes de seleccionar una muestra. La unidad de muestreo puede ser geográfica como el estado, el distrito, la aldea, etc., o la unidad de construcción, como casa, plana, etc., o puede ser una unidad social como familia, club, escuela, etc., o puede ser un individuo.
- Lista de origen: la lista de origen se conoce como «marco de muestreo» a partir del cual se extraerá la muestra. Consiste en los nombres de todos los elementos de un universo. Tal lista sería integral, correcta, confiable y apropiada, y la lista de origen debería ser un representante de la población.
- Tamaño de la muestra: el tamaño de la muestra se refiere al número de elementos que se seleccionarán del universo para constituir una muestra. La selección del tamaño de la muestra es un dolor de cabeza para el investigador. El tamaño no debe ser demasiado grande o demasiado pequeño, sino que debe ser óptimo. Una muestra óptima es aquella que cumple con los requisitos de eficiencia, representatividad, confiabilidad y flexibilidad. Los parámetros de interés en un estudio de investigación deben mantenerse a la vista, al tiempo que decide el tamaño de la muestra. El factor de costo, es decir, las condiciones presupuestarias también deben tenerse en cuenta.
- Procedimiento de muestreo: en el paso final del diseño de la muestra, un investigador debe decidir el tipo de muestra que usará, es decir, debe decidir sobre las técnicas que se utilizarán para seleccionar los elementos para la muestra.
- El diseño de la muestra debe dar como resultado una muestra verdaderamente representativa,
- El diseño de la muestra debe ser tal lo que resulta en un pequeño error de muestreo,
- El diseño de muestreo debe ser viable en el contexto de fondos disponibles para el estudio de investigación,
- El diseño de la muestra debe ser tal que el sesgo sistemático se pueda controlar de una mejor manera, y
- La muestra debe ser tal que los resultados del estudio de muestra se puedan aplicar, en general, para el universo con un nivel razonable de confianza.
¿Cuál es el diseño muestral?
Es un diseño de muestra en el que una población se divide en estratos en función de una determinada característica que se conoce por cada unidad de muestreo de la población, y luego selecciona muestras independientemente de cada estrato.
Cuando una pregunta de investigación requiere una respuesta en forma de una construcción que resume las similitudes conductuales y cognitivas entre un conjunto de personas, las respuestas precisas y precisas dependen de muestras diseñadas para buscar activamente la variación cultural que proviene de formas específicas de variación en las experiencias de la vida. . Al generalizar sobre casos en lugar de variables, el significado de la potencia cambia y el tamaño de la muestra depende del grado de similitud entre los casos.
Por ejemplo, en los análisis etnográficos, el poder se refiere a la confiabilidad y validez de las inferencias sobre el contenido de las similitudes conductuales y cognitivas entre los casos (la cultura o las culturas que comparten). El trabajo importante de Susan Weller ha demostrado que las estimaciones de la confiabilidad y la validez de esas inferencias provienen de la aplicación de la fórmula de profecía de Spearman-Brown al nivel promedio de similitud entre los casos. Si el nivel promedio de similitud es de 0.50, 9 casos producirán un coeficiente de confiabilidad de 0.90 y un coeficiente de validez de 0.95. Solo 18 casos producirán un coeficiente de confiabilidad de 0.95 y un coeficiente de validez de 0.97. Si el nivel promedio de acuerdo es de 0.60, solo se necesitan 12 casos para el mismo nivel de confiabilidad y validez. A medida que aumenta el nivel de similitud a 0.70, 0.80 y 0.90, el número de casos (tamaño de muestra) disminuye a 8, 6 y 3 casos, respectivamente. En un nivel promedio de acuerdo de 0.90, 3 casos producen un coeficiente de confiabilidad de 0.96 y un coeficiente de validez de 0.99.
Los diseños de muestra para el análisis etnográfico, por lo tanto, difieren en aspectos importantes de los diseños de muestras para análisis variables. No requieren grandes tamaños de muestra, y no dependen de la selección aleatoria. Diseños de muestra útiles para el estudio de culturas estratifican a la población mediante las experiencias de vida contrastantes que pueden producir diferencias culturales; emplear la selección de juicio de informantes clave y casos críticos; y seleccione otros casos en función de su disponibilidad, ya sea por conveniencia o mediante un procedimiento de bola de nieve. El tamaño de la muestra para estratos específicos se establece mediante cuota, dependiendo del nivel promedio de acuerdo. Los diseños de muestras eficientes rastrean los niveles de acuerdo y amplían los tamaños de muestra y los criterios de estratificación de cambio consistentes con los niveles de acuerdo y los límites culturales identificados.
El diseño de muestra de varias etapas en la Tabla I puede emplearse útilmente para un estudio etnográfico de la misma población y el mismo tema, con los siguientes cambios importantes en el procedimiento:
¿Qué son los diseños muestrales?
Un diseño de muestra se compone de dos elementos. El muestreo remanvido de una población finita se refiere a ese método de selección de muestras que le da a cada posible combinación de muestra una probabilidad igual de ser recogido y cada elemento en toda la población tiene una probabilidad igual de incluido en la muestra. Esto se aplica al muestreo sin reemplazo, es decir, una vez que se selecciona un elemento para la muestra, no puede aparecer nuevamente en la muestra (el muestreo con reemplazo se usa con menos frecuencia en el que el procedimiento el elemento seleccionado para la muestra se devuelve a la población antes del siguiente elemento se selecciona. En tal situación, el mismo elemento podría aparecer dos veces en la misma muestra antes de que se elija el segundo elemento). En resumen, las implicaciones del muestreo aleatorio (o muestreo aleatorio simple) son:
- Le da a cada elemento en la población una probabilidad igual de ingresar a la muestra; Y todas las opciones son independientes entre sí.
- Le da a cada posible combinación de muestra una probabilidad igual de ser elegida.
Manteniendo esto en vista, podemos definir una muestra aleatoria simple (o simplemente una muestra aleatoria) de una población finita como una muestra que se elige de tal manera que cada una de las muestras posibles de NCN tiene la misma probabilidad, 1/ncn, de ser de ser de ser de ser de ser de seleccionado. Para dejarlo más claro, tomamos una cierta población finita que consta de seis elementos (digamos a, b, c, d, e, f), es decir, n = 6. Suponga que queremos tomar una muestra de tamaño n = 3 de él . Luego están 6C3 = 20 posibles muestras distintas del tamaño requerido, y consisten en los elementos ABC, ABD, ABE, ABF, ACD, ACE, ACF, ADE, ADF, AEF, BCD, BCE, BCF, BDE, BDF, BEF, CDE, CDF, CEF y DEF. Si elegimos una de estas muestras de tal manera que cada una tiene la probabilidad 1/20 de ser elegida, luego llamaremos a esto una muestra aleatoria.
¿Qué es el marco muestral y un diseño muestral?
El marco de muestreo es la lista de la que se dibujan las unidades para la muestra. La «lista» puede ser una lista real de unidades, como en una guía telefónica a partir de la cual se tomarán muestras de números de teléfono, o alguna otra descripción de la población, como un mapa del que se tomarán muestras de áreas. Resultados del error de marco cuando el marco de muestreo no es una representación precisa y completa de la población de interés.
Los errores de marco surgen de inclusiones erróneas, exclusiones erróneas e múltiples inclusiones. Las inclusiones erróneas se producen si el marco incluye unidades que no están en la población de interés, por lo que las unidades inválidas tienen la posibilidad de ser incluidas en la muestra. Las exclusiones erróneas ocurren cuando faltan miembros de la población de interés en la lista para que no tengan posibilidades de ser muestreados. Se producen múltiples inclusiones si algunos miembros de la población aparecen varias veces en la lista para que tengan una mayor probabilidad de ser muestreados.
Para obtener un ejemplo fácil de estos tipos de errores de marco, considere el muestreo de hogares dentro de una ciudad utilizando las páginas blancas del teléfono como marco de muestreo. Algunos números enumerados en la guía telefónica ya no son números de trabajo porque las personas en el hogar que tenían el número se han mudado de la ciudad; Estas son inclusiones erróneas. Algunos hogares eligen no tener sus números de teléfono; Estas son exclusiones erróneas. Algunos hogares tienen múltiples listados en la guía telefónica porque tienen líneas telefónicas adicionales para un módem de computadora o una máquina de fax o para los niños; Estas son las inclusiones múltiples.
¿Qué son los marco muestral?
El objetivo es aligerar el trabajo asociado con el desarrollo de las actividades más comunes de una aplicación web por parte del desarrollador. Uno de los principios fundamentales se resume por el acrónimo Dry (no se repita), en el sentido de que la adopción de técnicas de reutilización de código se recomienda encarecidamente. Por ejemplo, muchos marco proporcionan estanterías para el acceso a las bases de datos, para la creación de TemplateHML o para administrar la sesión del usuario [1].
El marco generalmente establece el flujo de control de un programa y permite al usuario del marco «enganchar» a ese flujo exponiendo varios eventos [2]. Este modelo de diseño de «control del control» se considera un principio que define un marco y beneficia el código al imponer un flujo común para un equipo que todos pueden personalizar de manera similar [2]. Por ejemplo, algunos «Microframework» populares como Ruby Sinatra (que inspiró express.js) permiten ganchos de middleware antes y después de las solicitudes HTTP. Estas funciones de middleware pueden ser cualquier cosa y permitir al usuario definir el registro, la autenticación, la administración de sesiones y la redirección [3].
La mayoría del marco MVC sigue una arquitectura basada en push también llamada «basada en la acción». Estos marco utilizan acciones que realizan el procesamiento requerido y, por lo tanto, «transmiten» los datos al nivel de visualización para hacer los resultados [5]. Django, Ruby on Rails, Symfony, Spring MVC, Stripes, Sails.js, Codeigniter [6] son ejemplos de esta arquitectura.
¿Qué es el estudio muestral?
En estadísticas, una muestra es un conjunto de individuos representativos de una población. El muestreo tiene como objetivo obtener un mejor conocimiento de una o más poblaciones o subpoblaciones al estudiar una serie de muestras consideradas estadísticamente representativas. El uso de un plan de muestreo generalmente responde a una restricción práctica (falta de tiempo, espacio, evaluación destructiva de la producción, costo financiero, etc.) que prohíbe el estudio exhaustivo de la población.
Para garantizar una buena representación, generalmente es una muestra aleatoria, total o parcialmente.
Por lo tanto, las estadísticas estaban interesadas en los principios de muestreo, con el objetivo de garantizar o al menos estimar la confiabilidad de las conclusiones extraídas del estudio de muestras, pero extendidas a poblaciones enteras. Algunas de las preocupaciones de la teoría de muestreo son:
La estrategia de muestreo es un paso esencial en el diseño de experiencias científicas, con o sin tratamiento experimental particular, es decir, incluidas las medidas en un objeto (metrología), así como, por ejemplo, el monitoreo ambiental, de la salud y la biometría.
Los estadísticos asumen la población de un tamaño dado y asocian una ley de probabilidad, es el papel de la inferencia estadística o estadística matemática. En estas condiciones, la muestra se interpreta como un conjunto de variables aleatorias, de las cuales tenemos una supuesta realización de impresiones independientes. El análisis de las propiedades de la muestra permite estimar ciertas características de la población, para determinar la validez de estas estimaciones o ciertas hipótesis.
¿Qué es un estudio muestral?
En el análisis matemático, el estudio de la función de frase indica la aplicación práctica de teoremas y técnicas de cálculo infinitesimal en el caso específico de una función de la cual se conoce la expresión analítica. El estudio de funciones es útil para derivar explícitamente la información que describe el comportamiento de una función en su dominio. A menudo, la información obtenida a través de un estudio de funciones es suficiente para poder rastrear, incluso a mano, un diseñador gráfico cualitativo de la función estudiada y que en general, para las funciones a valores reales de una variable real, se representa en un Nivel cartesiano, incluso si en algunos casos podría ser más fácil recurrir a un sistema de coordenadas diferente. En general, con el «estudio de función» se refiere implícitamente al único y específico caso de las funciones reales de una sola variable real, pero con los cambios apropiados aún es posible adaptar las siguientes consideraciones también al caso de las funciones de múltiples variables reales , así como también para las funciones de una o más variables complejas.
No existe un procedimiento univocal prescrito por un teorema o corolario específico e indica el orden exacto de los pasajes y cálculos que se realizarán para poder estudiar correctamente una función. Puede tratar de darle una indicación máxima con una referencia particular al caso de las funciones de una sola variable real y específicamente en la que intenta obtener una representación en un sistema de referencia cartesiano Xoy { DisplayStyle xoy}.
En general, puede comenzar a estudiar una función clasificándola por tipo o «clase de pertenencia». Por ejemplo, una función puede ser elemental, polinomial, racional, irracional, trigonométrico, trascendente, especial, etc. Identifique inmediatamente cualquier pertenencia a un grupo de «funciones similares», es decir, con «propiedades comunes», así como poder determinar cualquier propiedad básica de la función, como cualquier igualdad o disparidad, puede simplificar los cálculos I utilizando las propiedades de la clase específica de funciones de pertenencia. En particular, puede ser muy útil reconocer y enumerar explícitamente cualquier composición de funciones involucradas en la ecuación de la función. Por ejemplo, se supone que tiene que estudiar una función en la forma f (x) = sin (x), { splatyle f (x) = sin { psi (x)},} donde ψ (x) { DisplayStyle psi (x)} es cualquier función. Ya que se sabe que la función de los senos asume valores estrictamente incluidos en el intervalo cerrado [−1; +1], { splatyle [-1; +1],} independientemente de la naturaleza de ψ (x), { DisplaysStyle psi (x),} clasificando f (x) { splatyle f (x)} Como una función trigonométrica y específicamente una función compuesta por la función de los senos, se puede concluir inmediatamente que los valores de F (x ) { displayStyle f (x)} debe pertenecer al intervalo [−1; +1]. { displayStyle [-1; +1].}
¿Qué es un procedimiento muestral?
Definición: Un procedimiento es un método consolidado para llevar a cabo una actividad, generalmente con pasajes realizados en un orden prescrito.
¿Cuál es la definición de procedimientos? Estos sistemas son básicamente acciones secuenciales diseñadas para completar una actividad. En el mundo de los negocios, todas las operaciones comerciales se pueden dividir en categorías llamadas procesos. Estos procesos son los elementos constitutivos de los procedimientos de la empresa.
Los procedimientos generalmente no cambian y se realizan en el mismo orden para proporcionar resultados finales estandarizados y coherentes. Las guías, la capacitación y los cursos de tutoriales son métodos típicos para comunicar los procesos a los empleados de una organización, para que puedan implementar los procedimientos para lograr los objetivos de la empresa.
En un contexto corporativo, los procedimientos deben ser muy claros y dejar algunas áreas grises para la interpretación del personal. Las características de un procedimiento claro se basarían en hechos, concisos, concretos, instructivos y relevantes. Los funcionarios y los gerentes a menudo proporcionan acciones para acciones que requieren documentación o tienen efectos negativos si ciertas acciones no se realizan correctamente.
Jennifer recibe una nueva guía para los empleados que le proporcionan pasos detallados sobre cómo registrar a un cliente e ingresar su información. Hay procesos clave que deben realizar en un orden específico. Algunos documentos en papel deben presentarse en términos rigurosos. No presentar documentos a tiempo puede causar una pérdida de ganancias para la empresa y una pérdida de servicio para el cliente.
¿Qué es un diseño muestral Probabilistico?
Dada la importancia del uso de la Web por parte del consumidor, quien no solo busca información sobre los productos/servicios que tiene la intención de comprar (en este caso hablamos del comercio de información), sino que lleva a cabo documentos de compra reales (hay Hablar de comercio electrónico), es casi deber, para las empresas, llevar a cabo investigaciones que sirven para rastrear el comportamiento del consumidor dentro del ciberespacio. De ahí la necesidad de adaptar la investigación de mercado en la web.
En primer lugar, debe entenderse que las muestras de investigación de mercado se pueden clasificar de muchas maneras: una distinción de importancia fundamental es que entre las muestras probabilísticas y las muestras no probabilísticas. Profundizamos las muestras no probabilísticas, ya que representan el modo de muestreo más utilizado en la encuesta de Internet y en las encuestas de opinión. Las principales características de estos tipos de muestreo son:
- Se desconoce la probabilidad, para la unidad única, de ser incluida en la muestra;
- No permita llevar a cabo una inferencia sobre las propiedades estadísticas de los métodos de estimación utilizados;
- Existe un alto riesgo de distorsionar la representatividad de la población;
- No requiere una lista de muestreo.
Hay dos formas de muestreo no probabilístico: muestras de opciones razonadas y muestras fortuitas (al azar). Analizamos el muestreo fortuito o al azar.
El término al azar podría confundirse con el término casualmente: en realidad, esta muestra no se forma ni con la ayuda de técnicas aleatorias, ni mediante los siguientes procedimientos que implican la preferencia por el detector para ciertas unidades de la muestra en comparación con otras. Por lo tanto, es muy importante subrayar que en este tipo de muestreo no hay un concepto de aleatoriedad y, en consecuencia, no se puede hacer una inferencia estadística: los resultados de la muestra a la población no pueden generalizarse, los resultados se refieren solo a las unidades de análisis de a lo que fueron extraídos. Este es el límite más importante
¿Cómo sé si una muestra es probabilística?
Descubrimos en la última publicación que las muestras se pueden obtener de muchas maneras.
Sin embargo, el objetivo es obtener una muestra representativa (en la medida de lo posible).
Según la forma en que se obtienen muestras, los estadísticos pueden clasificar ampliamente las técnicas de muestreo como «probabilísticas» o «no probabilistas».
¿Qué significa «probabilístico»? En el contexto del muestreo, simplemente significa que cada sujeto (o unidad de muestreo) tiene una probabilidad conocida (o probabilidad) de selección. La probabilidad (o probabilidad) de selección no debe ser cero.
Tenga en cuenta que conocer la probabilidad (o probabilidad) de la selección no significa que sepamos quién será seleccionado: si sé que la probabilidad de selección es 0.5 (o 50%), sé que la mitad de la población será seleccionada, pero No sé quién estará en ese 50%.
¿Qué se entiende por «aleatorio»? En comprensión común, los medios aleatorios arbitrarios o ad-hoc. En estadísticas, sin embargo, «aleatorio» significa impredecible o no guiado. (Esto da automáticamente a miembros elegibles de una población de posibilidades similares de ser seleccionados).
Supongamos que necesito elegir 10 personas de una multitud de 100 personas. Si alineé a todos y luego elegí cada décima persona, eso no es «aleatorio», porque cualquiera podría adivinar quién sería seleccionado a continuación.
Si, por otro lado, le asigné a cada persona un número de 1 a 100; Hizo 100 fisias numeradas de 1 a 100; poner todas las fechas en un contenedor; sacudió el contenedor vigorosamente; y eligió 10 chits del contenedor, que es «aleatorio».
Artículos Relacionados: