¿Qué puede hacer que una muestra no sea representativa de su población? Uno de los más
Las causas frecuentes son el error de muestreo.
El error de muestreo comprende las diferencias entre la muestra y el
población que se debe únicamente a las unidades particulares que han sido
seleccionado.
Por ejemplo, supongamos que se miden y se miden una muestra de 100 mujeres estadounidenses
Todo lo que se encuentra más alto que seis pies. Está muy claro incluso sin ninguna
estadística demuestra que esta sería una muestra altamente no representativa que conduce a
conclusiones no válidas. Esta es una ocurrencia muy poco probable porque naturalmente tal
Los casos raros se distribuyen ampliamente entre la población. Pero puede ocurrir.
Afortunadamente, este es un error muy obvio y se puede enviar muy fácilmente.
El error más peligroso es el error de muestreo menos obvio contra el cual
La naturaleza ofrece muy poca protección. Un ejemplo sería como una muestra en la que
La altura promedio se exagera por solo una pulgada o dos en lugar de un pie
Lo cual es más obvio. Es el error discreto el que es de gran preocupación.
Hay dos causas básicas para el error de muestreo. Uno es casualidad: ese es el
Error que ocurre solo por la mala suerte. Esto puede dar lugar a un típico
opciones. Las unidades inusuales en una población existen y siempre hay un
posibilidad de que se elija un número anormalmente grande de ellos. Por ejemplo,
En un estudio reciente en el que estaba mirando la cantidad de árboles, seleccioné un
muestra de hogares al azar pero lo suficientemente extraño, los dos hogares en el
toda la población, que tenía el mayor número de árboles (10,018 y 6345) eran
Ambos seleccionados haciendo que la muestra sea promedio más alta de lo que debería ser. La media
Con estos dos extremos eliminados había 828 árboles. La principal protección AGAISNT ESTO
El tipo de error es usar una muestra lo suficientemente grande. La segunda causa de muestreo es
sesgo de muestreo.
¿Qué es un muestreo conclusion?
Los resultados del presente estudio muestran que se observaron desviaciones significativas del parámetro de población (50% de hombres) en muchos países de ESS y que se asociaron con la capacidad de contacto o cooperación de socios en parejas heterosexuales (apoyo a la hipótesis H1). Se encontró que la magnitud de estas desviaciones difiere entre los métodos de muestreo cuando los socios también diferían en términos de su capacidad de contacto (en submuestras con niños). Por lo tanto, la hipótesis H2 fue parcialmente apoyada. En submuestras con niños, PRS se asoció con la mejor calidad de datos, ya que las desviaciones más bajas del parámetro de población se encontraron con este método de muestreo. Sin embargo, los resultados para submuestras con socios retirados muestran que las desviaciones muy pronunciadas también son posibles en el caso de PRS.
Los resultados para submuestras con niños están en línea con la explicación de que el comportamiento del entrevistador relacionado con las sustituciones está involucrada, ya que, como las desviaciones esperadas del parámetro de población, variaron con el grado de libertad del entrevistador para influir en la realización de la muestra. Sodur (1997) y Kohler informaron resultados comparables. Es menos plausible explicar entrevistas a hombres menos del 50% del tiempo por rechazo diferencial, ya que en tales casos se espera que la proporción de hombres sea superior al 50%. A continuación, no se espera que el rechazo diferencial varíe entre los diferentes métodos de muestreo. Para los jubilados, entrevistando a hombres más del 50% del tiempo se encontró en varios países, pero solo en rondas individuales. Esta baja estabilidad de las desviaciones de una relación de género del 50% también puede asociarse con el impacto del entrevistador en lugar de la rechazo diferencial, ya que este último sería bastante estable en un país durante el período de tiempo considerado en el análisis. Sin embargo, dado que el presente estudio no aplicó un diseño experimental, es importante abordar el rechazo diferencial y las sustituciones a través de una investigación adicional para permitir una mejor diferenciación, así como para referencias causales.
A pesar de que las desviaciones de un parámetro de población del 50% variaron en algunos países en las rondas, en general su magnitud no cambió significativamente durante el paso del tiempo a pesar de los procedimientos de recopilación de datos mejorados en el ESS (cf. Koch et al. 2009). Además, las desviaciones del parámetro de la población no dependían del recolector de datos ni eran específicos del país.
Los resultados también implican que los procedimientos de pago y control del entrevistador pueden reducir las sustituciones. Sin embargo, debe tenerse en cuenta que solo la consideración limitada de los procedimientos de pago y control fue posible debido a su baja variación en los datos o la información limitada disponible en la documentación de la encuesta.
También debe considerarse que los resultados presentados aquí se basan en submuestras específicas y no se pueden utilizar para generalizar sobre la muestra completa del ESS. Sin embargo, la «ausencia de un sesgo en las submuestras no garantiza la ausencia de sesgo para toda la muestra» (Kohler 2007, página 55). Además, un análisis centrado en grupos especiales a menudo puede ser de interés (por ejemplo, cuáles son las opiniones de los padres con hijos o de las personas empleadas).
¿Qué es un muestreo resumen?
» Sabías ? «: Este es el nombre de esta nueva sección que nos complace abrir hoy con Philippe Guilbert, estudios expertos con organizaciones profesionales (Syntec Conseil, Esomar). Con un objetivo simple: hacerle descubrir los resultados del trabajo relacionados con los problemas éticos asociados con los estudios de marketing, o incluso con los códigos y estándares de la profesión. Una manera excelente también, en unos minutos y gracias a Philippe Guilbert, una referencia en esta área, para validar sus conocimientos, integrar noticias sobre los fundamentos de nuestro universo y acceder a los documentos de referencia si es necesario. Para inaugurar esta sección, era difícil encontrar un mejor tema que el de la representatividad de los estudios. Un término que usamos casi todos los días… pero sin necesariamente conocer el significado preciso. Philippe Guilbert, por lo tanto, resume la mayor parte de lo que es bueno saber.
La muestra representativa, en el corazón de las encuestas, acaba de tener una definición oficial del estándar ISO 20252: 2019: una muestra para la cual la distribución de características importantes es aproximadamente idéntica a la de la población objetivo.
SynTec Conseil también ha publicado una definición detallada de la población nacional («Representante nacional») de la muestra o utiliza otros grupos de edad («de 15 a 64 años, o aún se preocupa, o aún se preocupa. Otras poblaciones (usuarios de Internet, consumidores de un producto, votantes, empleados, negocios, etc.). La metodología también debe establecer los criterios de representatividad relevantes para la encuesta, y los medios explotados durante las etapas de muestreo o recuperación para obtener distribuciones cercanas a las del objetivo en estos criterios.
¿Qué es muestreo resumen?
Una muestra es cualquier subconjunto de unidades recolectadas de alguna manera de una población. Una vez que se ha recopilado una muestra, se puede obtener estadísticas de muestra que midan las características de la muestra para estimar el valor de los parámetros de la población que describen las características de una población.
Si bien una población sería la primera opción para el análisis, la mayoría de la investigación utiliza una muestra porque no es factible estudiar a toda la población.
Cualquier diferencia entre una población y una muestra se define como sesgo. Una muestra no representativa conducirá a conclusiones inexactas sobre la población.
El capítulo analiza cuatro ejemplos de muestras de probabilidad, definidas como muestras para las cuales cada elemento en la población tiene una probabilidad conocida de inclusión en la muestra. La población particular de la que realmente se dibuja una muestra se llama marco de muestreo, y debe especificarse claramente.
Estos métodos de muestreo son la primera opción porque producen las muestras más representativas. Son muestras de probabilidad.
- En una muestra aleatoria simple, cada elemento y combinación de elementos en una población tienen las mismas posibilidades de selección.
- Se genera una muestra sistemática seleccionando elementos de una lista de la población a un intervalo predeterminado, es decir, cada 50 ° elemento en la lista.
- Una muestra estratificada se extrae de una población que se ha subdividido en dos o más estratos en función de una sola característica, y los elementos se seleccionan de cada estrato en proporción a la representación de cada estrato en toda la población. Una muestra estratificada desproporcionada también puede ser útil cuando un investigador desea representar demasiado un grupo que, debido a su pequeño tamaño en la población, probablemente no representa un porcentaje lo suficientemente grande de la muestra para hacer inferencias de calidad.
¿Qué es el muestreo y su importancia?
En general, el muestreo permite a los investigadores obtener suficientes datos para responder a las preguntas de investigación sin tener que consultar a toda la población, ahorrando tiempo y dinero. Sin embargo, el muestreo difiere dependiendo de si el estudio es cuantitativo o cualitativo.
El muestreo cuantitativo se basa en dos elementos: análisis de potencia (típicamente usando g*power3, o similar), y selección aleatoria. El análisis de potencia se aplica para determinar el tamaño mínimo de la muestra necesario para garantizar que la muestra y los datos sean estadísticamente significativos. Se requiere muestreo aleatorio para garantizar que no haya sesgo y que toda la población esté representada adecuadamente en la muestra. Tenga en cuenta que para el muestreo aleatorio al trabajo, la muestra debe tomarse de una población conocida, de modo que cada enésima persona o artículo se pueda seleccionar aleatoriamente.
El muestreo cualitativo requirió muchos menos participantes que cuantitativos, ya que el objetivo no es lograr significación estadística, sino más bien, la saturación de datos, es decir, cuando los temas comienzan a repetirse dentro de cada respuesta de los participantes posteriores durante la fase de análisis de datos. Los expertos varían en el número de participantes necesarios para la saturación de datos, pero generalmente cae entre 10 y 25. Además, el muestreo aleatorio no suele ser requerido ni apropiado para la recopilación de datos cualitativos, sino más bien conveniencia o propósito. De los dos, el propósito parece ser el enfoque preferido ya que los participantes son atacados, en función de su demografía particular.
¿Qué importancia tiene conocer la técnica de muestreo?
El mundo se dirige hacia la IA, los big data y el aprendizaje automático y vemos altos volúmenes de datos a diario. Todos estos datos pueden ser significativos solo cuando analizamos y obtenemos algunas ideas de ellos. Los datos son la moneda en diseños experimentales, así como dominio de aprendizaje automático. Por lo tanto, es importante que se recolecte correctamente y se analice de manera efectiva.
El uso de varias técnicas de muestreo juega un papel muy importante en la reducción de los costos, mejorar la precisión, crear más alcance y lograr una mayor velocidad. Lo importante que se debe tener en cuenta es que la población de muestreo debería coincidir con la población objetivo. Entonces, ¿cómo sabemos qué técnica de muestreo usar para mejorar la eficiencia de muestreo?
El muestreo estadístico es el proceso de selección de subconjuntos pequeños llamados unidades de muestreo o unidades de la población objetivo. Hay dos tipos de métodos de muestreo:
- Muestreo de probabilidad: en este método, podemos seleccionar un conjunto de muestras distintas, asignarles diferentes probabilidades y usar un método para estimar las características de muestra que pueden hacer inferencias estadísticas sobre la población objetivo.
- Muestreo de no probabilidad: este tipo de muestreo no tiene un elemento de selección aleatoria involucrada, es decir, su selección generalmente se basa en la conveniencia, accesibilidad u otros criterios. Sin embargo, estos métodos carecen de flexibilidad, es decir, si un método parece funcionar bien en una comparación, esto no garantiza que funcionará bien en diferentes circunstancias.
- Población (N): el grupo o el público objetivo que desea sacar conclusiones.
- Muestra: el grupo específico seleccionado al azar de los que extrae analogías.
- Unidades de muestreo o unidades (N): la población se divide inicialmente en varias partes llamadas unidades de muestreo que cubren toda la población y no debe superponerse.
- Marco: la construcción de la lista de unidades de muestreo se llama marco.
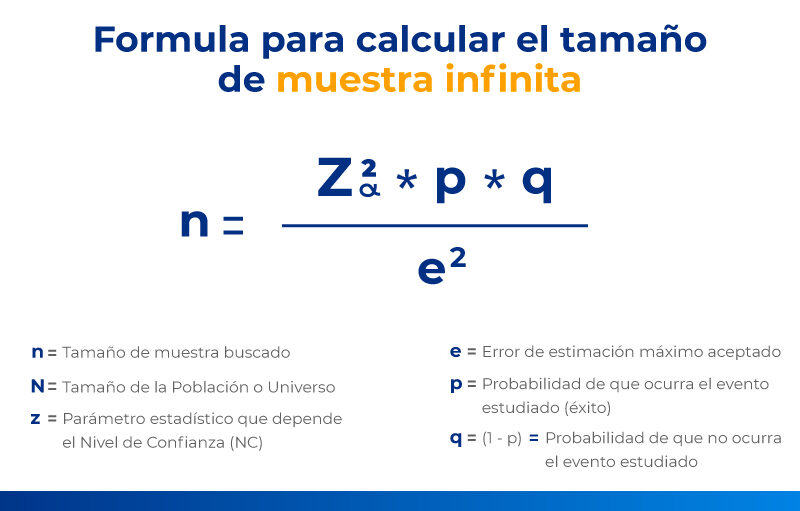
- Tamaño de la muestra: la estimación aproximada del tamaño de la muestra se puede hacer a partir del conocimiento del grado de precisión requerido.
Para aumentar cualquier eficiencia de muestreo, necesitamos saber el tipo de método de muestreo utilizado. ¿Por qué el bosque aleatorio utiliza un muestreo aleatorio simple con reemplazo en lugar de sin reemplazo? ¿Es una opción factible usar Train_Test_Split para la validación de datos si sus datos no son lo suficientemente grandes o si su análisis requiere estratificación? Si no usamos la técnica de muestreo correcta antes de ejecutar nuestros modelos, puede ser posible que introduzcamos una cantidad significativa de sesgo de muestreo.
¿Qué es Introduccion al muestreo?
- El grupo de casos posibles es demasiado grande (por ejemplo, 260 millones de estadounidenses) – costaría demasiado
Y tarda demasiado - No quiero usar los casos: por ejemplo, al probar bombillas para ver cuánto tiempo
Por último, tomas una bombilla y la dejas hasta que se quema. No puedes probar todas las bombillas
De esta manera, porque todo su objetivo es vender las bombillas, no quemarlas. - No es necesario examinar todos los casos: para la mayoría de los fines, tomar una muestra produce un
Estimaciones que son lo suficientemente precisas. - La compensación es que el muestreo introduce algún error. No entrevistaste
todos, por lo que ciertas opiniones o combinaciones de opiniones no se representarán en su
datos. Cuando la población es muy diversa, su muestra no puede incluir todo lo posible
combinaciones de atributos que se encuentran en la población, tales negros y blancos, hombres
y mujeres, pacientes cardíacos no pacientes, mujeres negras, hombres blancos, mujeres blancas con corazón
Problemas a quienes les gusta a Oprah y no le gusta el aliado McBeal, etc. - La población es el universo de los casos. Es el grupo que finalmente quieres
decir algo sobre. Por ejemplo, si quieres informar «en qué piensan los estadounidenses
Clinton ‘, entonces la población es todo estadounidense. - Los elementos son los casos individuales en la población (generalmente, personas)
- La relación de muestreo es el tamaño de la muestra dividida por el tamaño de la población. Contrariamente a
Creencia popular, una gran relación de muestreo no es crucial. - El marco de muestreo es una lista específica de nombres a partir de los cuales serán los elementos de muestra
elegido. La encuesta literaria de resumen en 1936 usó una muestra de 10 millones, extraída de
Listas gubernamentales de propietarios de automóviles y telefónicos. Predicho que Alf Landon vencería
Franklin Roosevelt por un amplio margen. Pero en cambio, Roosevelt ganó por un deslizamiento de tierra. La razón
fue que el marco de muestreo no coincidía con la población. Solo los automóviles de propiedad rica
y teléfonos, y ellos fueron los que favorecieron a Landon. - Reemplazo. El muestreo con reemplazo significa que después de sacar un nombre de
El sombrero y grabarlo, pones el nombre y se puede elegir nuevamente. Muestreo sin
El reemplazo significa que una vez que extrae el nombre, no está disponible para ser elegido nuevamente. - Parcialidad. Errores sistemáticos producidos por su procedimiento de muestreo. Por ejemplo, si
Pruebas a las personas y les preguntas si miran a Ally McBeal, pero el porcentaje siempre
sale demasiado alto (tal vez porque estás entrevistando a tus amigos y a todo tu grupo
realmente le gusta ally mcbeal) - Quien pase por su oficina; ¿Quién está en la calle cuando vienen las tripulaciones de la cámara?
afuera - Si tiene una opción, no use este método. A menudo produce respuestas realmente incorrectas,
Porque ciertos atributos tienden a agruparse con ciertas variables geográficas y temporales.
Por ejemplo, a las 8 am en Nueva York, la mayoría de las personas en la calle son trabajadores que se dirigen a su
trabajos. A las 10 a.m., hay muchas más personas que no trabajan, y la proporción de mujeres es
mucho más alto. A la medianoche, hay jóvenes y asaltantes. - Muestreo al azar dentro de las categorías (por ejemplo, los primeros 5 hombres por venir)
- Es una mejora, pero aún tiene problemas. ¿Cómo sabes qué categorías son clave? Cómo
¿Muchos obtienen de cada categoría? - El juicio de expertos elige casos útiles para el estudio
- Bueno para el trabajo exploratorio y cualitativo y para la prueba previa de un cuestionario.
- Reclutar personas basadas en la recomendación de personas que acaba de entrevistar
- Útil para estudiar poblaciones invisibles/ilegales, como adictos a las drogas
El muestreo de probabilidad es cualquier esquema de muestreo en el que la probabilidad de elegir cada
El individuo es el mismo (o al menos conocido, por lo que puede reajustarse matemáticamente). Estas
También se llaman muestreo aleatorio. Requieren más trabajo, pero son mucho más precisos. Ellos
también permita al investigador calcular la cantidad de error que puede esperar, y esto es
realmente importante.
- El grupo de casos posibles es demasiado grande (por ejemplo, 260 millones de estadounidenses) – costaría demasiado
Y tarda demasiado - No quiero usar los casos: por ejemplo, al probar bombillas para ver cuánto tiempo
Por último, tomas una bombilla y la dejas hasta que se quema. No puedes probar todas las bombillas
De esta manera, porque todo su objetivo es vender las bombillas, no quemarlas. - No es necesario examinar todos los casos: para la mayoría de los fines, tomar una muestra produce un
Estimaciones que son lo suficientemente precisas. - La compensación es que el muestreo introduce algún error. No entrevistaste
todos, por lo que ciertas opiniones o combinaciones de opiniones no se representarán en su
datos. Cuando la población es muy diversa, su muestra no puede incluir todo lo posible
combinaciones de atributos que se encuentran en la población, tales negros y blancos, hombres
y mujeres, pacientes cardíacos no pacientes, mujeres negras, hombres blancos, mujeres blancas con corazón
Problemas a quienes les gusta a Oprah y no le gusta el aliado McBeal, etc. - La población es el universo de los casos. Es el grupo que finalmente quieres
decir algo sobre. Por ejemplo, si quieres informar «en qué piensan los estadounidenses
Clinton ‘, entonces la población es todo estadounidense. - Los elementos son los casos individuales en la población (generalmente, personas)
- La relación de muestreo es el tamaño de la muestra dividida por el tamaño de la población. Contrariamente a
Creencia popular, una gran relación de muestreo no es crucial. - El marco de muestreo es una lista específica de nombres a partir de los cuales serán los elementos de muestra
elegido. La encuesta literaria de resumen en 1936 usó una muestra de 10 millones, extraída de
Listas gubernamentales de propietarios de automóviles y telefónicos. Predicho que Alf Landon vencería
Franklin Roosevelt por un amplio margen. Pero en cambio, Roosevelt ganó por un deslizamiento de tierra. La razón
fue que el marco de muestreo no coincidía con la población. Solo los automóviles de propiedad rica
y teléfonos, y ellos fueron los que favorecieron a Landon. - Reemplazo. El muestreo con reemplazo significa que después de sacar un nombre de
El sombrero y grabarlo, pones el nombre y se puede elegir nuevamente. Muestreo sin
El reemplazo significa que una vez que extrae el nombre, no está disponible para ser elegido nuevamente. - Parcialidad. Errores sistemáticos producidos por su procedimiento de muestreo. Por ejemplo, si
Pruebas a las personas y les preguntas si miran a Ally McBeal, pero el porcentaje siempre
sale demasiado alto (tal vez porque estás entrevistando a tus amigos y a todo tu grupo
realmente le gusta ally mcbeal) - Quien pase por su oficina; ¿Quién está en la calle cuando vienen las tripulaciones de la cámara?
afuera - Si tiene una opción, no use este método. A menudo produce respuestas realmente incorrectas,
Porque ciertos atributos tienden a agruparse con ciertas variables geográficas y temporales.
Por ejemplo, a las 8 am en Nueva York, la mayoría de las personas en la calle son trabajadores que se dirigen a su
trabajos. A las 10 a.m., hay muchas más personas que no trabajan, y la proporción de mujeres es
mucho más alto. A la medianoche, hay jóvenes y asaltantes. - Muestreo al azar dentro de las categorías (por ejemplo, los primeros 5 hombres por venir)
- Es una mejora, pero aún tiene problemas. ¿Cómo sabes qué categorías son clave? Cómo
¿Muchos obtienen de cada categoría? - El juicio de expertos elige casos útiles para el estudio
- Bueno para el trabajo exploratorio y cualitativo y para la prueba previa de un cuestionario.
- Reclutar personas basadas en la recomendación de personas que acaba de entrevistar
- Útil para estudiar poblaciones invisibles/ilegales, como adictos a las drogas
Dibuja al azar cartas del sombrero; En Excel, hay una función para conectar un número aleatorio
a cada celda, luego ordene y tome n más grande)
más fácil matemáticamente)
Porcentaje de encuestados que observan aliados McBeal) que son diferentes de la población
parámetros
Otras palabras, si tomaste 150 muestras diferentes de estadounidenses, cada una de 300 personas y
calculó el porcentaje que, como Ally McBeal, en cada una de las muestras, luego promedió todo
Esos porcentajes juntos, eso debería igualar el porcentaje «real» de todos
A los estadounidenses les gusta el aliado McBeal
aumenta, el promedio de esas muestras converge en el parámetro de población
de la población, dando lugar a intervalos de confianza
Ejemplo. Una empresa de 680 empleados quiere saber si molestar
con instituir un programa para tratar con la toma de drogas de los empleados. Para averiguarlo, lo probarán
Una muestra de empleados en anónimo: si una persona da positivo, la empresa
No sé quién es y no intentará averiguarlo. El objetivo es excluir únicamente lo que
El porcentaje de la empresa podría estar haciendo drogas. Si el porcentaje es lo suficientemente alto, el
La compañía considerará instituir un programa de pruebas de drogas obligatorio. Dado este objetivo,
Un diseño de muestreo aleatorio simple es perfecto: los resultados se generalizarán en general
empresa.
- El grupo de casos posibles es demasiado grande (por ejemplo, 260 millones de estadounidenses) – costaría demasiado
Y tarda demasiado - No quiero usar los casos: por ejemplo, al probar bombillas para ver cuánto tiempo
Por último, tomas una bombilla y la dejas hasta que se quema. No puedes probar todas las bombillas
De esta manera, porque todo su objetivo es vender las bombillas, no quemarlas. - No es necesario examinar todos los casos: para la mayoría de los fines, tomar una muestra produce un
Estimaciones que son lo suficientemente precisas. - La compensación es que el muestreo introduce algún error. No entrevistaste
todos, por lo que ciertas opiniones o combinaciones de opiniones no se representarán en su
datos. Cuando la población es muy diversa, su muestra no puede incluir todo lo posible
combinaciones de atributos que se encuentran en la población, tales negros y blancos, hombres
y mujeres, pacientes cardíacos no pacientes, mujeres negras, hombres blancos, mujeres blancas con corazón
Problemas a quienes les gusta a Oprah y no le gusta el aliado McBeal, etc. - La población es el universo de los casos. Es el grupo que finalmente quieres
decir algo sobre. Por ejemplo, si quieres informar «en qué piensan los estadounidenses
Clinton ‘, entonces la población es todo estadounidense. - Los elementos son los casos individuales en la población (generalmente, personas)
- La relación de muestreo es el tamaño de la muestra dividida por el tamaño de la población. Contrariamente a
Creencia popular, una gran relación de muestreo no es crucial. - El marco de muestreo es una lista específica de nombres a partir de los cuales serán los elementos de muestra
elegido. La encuesta literaria de resumen en 1936 usó una muestra de 10 millones, extraída de
Listas gubernamentales de propietarios de automóviles y telefónicos. Predicho que Alf Landon vencería
Franklin Roosevelt por un amplio margen. Pero en cambio, Roosevelt ganó por un deslizamiento de tierra. La razón
fue que el marco de muestreo no coincidía con la población. Solo los automóviles de propiedad rica
y teléfonos, y ellos fueron los que favorecieron a Landon. - Reemplazo. El muestreo con reemplazo significa que después de sacar un nombre de
El sombrero y grabarlo, pones el nombre y se puede elegir nuevamente. Muestreo sin
El reemplazo significa que una vez que extrae el nombre, no está disponible para ser elegido nuevamente. - Parcialidad. Errores sistemáticos producidos por su procedimiento de muestreo. Por ejemplo, si
Pruebas a las personas y les preguntas si miran a Ally McBeal, pero el porcentaje siempre
sale demasiado alto (tal vez porque estás entrevistando a tus amigos y a todo tu grupo
realmente le gusta ally mcbeal) - Quien pase por su oficina; ¿Quién está en la calle cuando vienen las tripulaciones de la cámara?
afuera - Si tiene una opción, no use este método. A menudo produce respuestas realmente incorrectas,
Porque ciertos atributos tienden a agruparse con ciertas variables geográficas y temporales.
Por ejemplo, a las 8 am en Nueva York, la mayoría de las personas en la calle son trabajadores que se dirigen a su
trabajos. A las 10 a.m., hay muchas más personas que no trabajan, y la proporción de mujeres es
mucho más alto. A la medianoche, hay jóvenes y asaltantes. - Muestreo al azar dentro de las categorías (por ejemplo, los primeros 5 hombres por venir)
- Es una mejora, pero aún tiene problemas. ¿Cómo sabes qué categorías son clave? Cómo
¿Muchos obtienen de cada categoría? - El juicio de expertos elige casos útiles para el estudio
- Bueno para el trabajo exploratorio y cualitativo y para la prueba previa de un cuestionario.
- Reclutar personas basadas en la recomendación de personas que acaba de entrevistar
- Útil para estudiar poblaciones invisibles/ilegales, como adictos a las drogas
Dibuja al azar cartas del sombrero; En Excel, hay una función para conectar un número aleatorio
a cada celda, luego ordene y tome n más grande)
más fácil matemáticamente)
Porcentaje de encuestados que observan aliados McBeal) que son diferentes de la población
parámetros
Otras palabras, si tomaste 150 muestras diferentes de estadounidenses, cada una de 300 personas y
calculó el porcentaje que, como Ally McBeal, en cada una de las muestras, luego promedió todo
Esos porcentajes juntos, eso debería igualar el porcentaje «real» de todos
A los estadounidenses les gusta el aliado McBeal
aumenta, el promedio de esas muestras converge en el parámetro de población
de la población, dando lugar a intervalos de confianza
como hombres y mujeres. Luego muestra al azar dentro de los estratos.
Elija al azar 51 hombres (de la población de todos los hombres) y, por separado, elija 49
hembras. Se garantiza que nuestra muestra tendrá exactamente la proporción correcta de sexos.
La muestra aleatoria puede extrañarlos por completo.
Ejemplo. El vicepresidente de recursos humanos de una gran fabricación es
considerando crear un programa de gestión de estrés para los empleados. Para tener una idea de lo que
tipos de necesidades El programa tendría que satisfacer, entrevistará a una muestra de 50 empleados
primero. Si ella hace una muestra aleatoria simple, es posible que su muestra no incluya ninguna
Representantes de algunos de los departamentos más pequeños, justo por casualidad. Ya que ella sabe que
Los diferentes tipos de trabajos dentro de la empresa producen diferentes tipos de estrés, ella quiere
Obtenga muestras separadas de los trabajadores (que manejan productos químicos peligrosos), los capataces (que
equilibrar los intereses de los trabajadores con la gerencia) y los gerentes (que son
responsable ante los accionistas). Entonces ella usa una muestra aleatoria estratificada.
¿Qué es la introducción al muestreo?
2
C6-2 Estudio de mercado / encuesta / sugerencias de muestreo / muestreo Su objetivo de descubrir información sobre una población en particular, un estudio de mercado / encuesta / muestreo consiste en tomar un subconjunto de unidades estadísticas de una población para conocer mejor las características (preferencias, ingresos , intención de compra, etc.) menos costoso que un censo que considera todas las unidades estadísticas de la población, aunque más precisos, los censos son más caros y generalmente toman más tiempo para obtener información válida, se debe tomar un representante de la población apropiado métodos
4
C6-4 Fluctuaciones de muestreo de un promedio Es fácil notar que si tomamos todas las muestras posibles del mismo tamaño N de una población de tamaño n, el promedio aritmético calculado en cada muestra puede variar de una muestra a la otra, por lo tanto, hay fluctuaciones en el promedio aritmético de muestras alrededor del promedio de la población
5
Distribución de muestreo C6-5 La distribución de probabilidad de una estadística se denomina distribución de muestreo ya que las variaciones son atribuibles al muestreo, por ejemplo, la distribución de muestreo del promedio x
6
C6-6 esperanza matemática de la distribución de x, es decir, una variable estadística x que sigue una ley de probabilidad de promedio e (x) = y varianza var (x) = 2 si tomamos una muestra aleatoria de tamaño n de un Población infinita (o de una población finita y una muestra con descuento), entonces la muestra promedio X sigue una ley de probabilidad de esperanza matemática
Artículos Relacionados: