
Este conjunto de datos del tamaño n = 51 es para los 50 estados y el Distrito de Columbia en los Estados Unidos (pobreza.txt). Las variables son Y = año 2002 Tasa de natalidad por cada 1000 hembras de 15 a 17 años y X = tasa de pobreza, que es el porcentaje de la población del estado que vive en hogares con ingresos por debajo del nivel de pobreza definido por el gobierno federal. (Fuente de datos: mente en estadísticas, tercera edición, UTTS y Heckard).
La gráfica de los datos a continuación (tasa de natalidad en la vertical) muestra una relación generalmente lineal, en promedio, con una pendiente positiva. A medida que aumenta el nivel de pobreza, la tasa de natalidad para las mujeres de 15 a 17 años también tiende a aumentar.
El siguiente gráfico muestra una línea de regresión superpuesta en los datos.
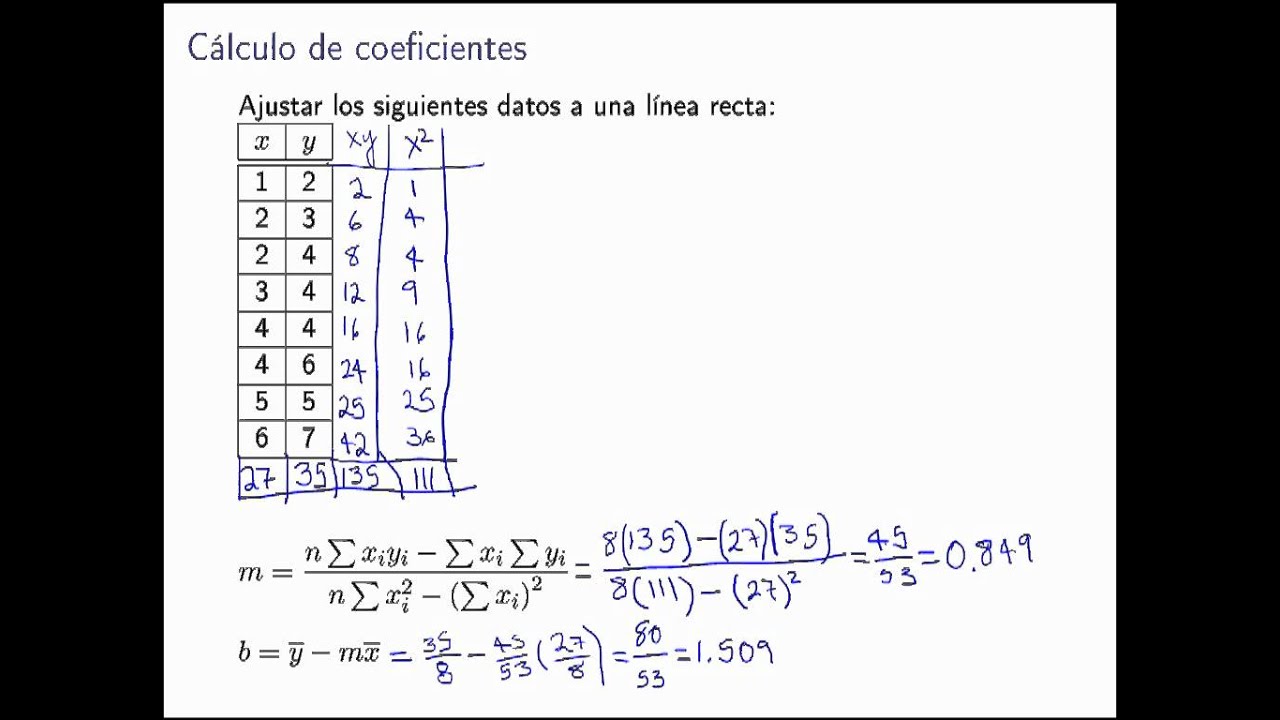
La ecuación de la línea de regresión ajustada se da cerca de la parte superior de la trama. La ecuación realmente debería afirmar que es para la tasa de natalidad «promedio» (o la tasa de natalidad «predicha» también estaría bien) porque una ecuación de regresión describe el valor promedio de y en función de una o más variables X. En notación estadística, la ecuación podría escribirse ( hat {y} = 4.267 + 1.373x ).
- La interpretación de la pendiente (valor = 1.373) es que la tasa de natalidad de 15 a 17 años aumenta 1.373 unidades, en promedio, para cada unidad (una por ciento) aumenta en la tasa de pobreza.
- La interpretación de la intersección (valor = 4.267) es que si hubiera estados con tasa de pobreza = 0, el promedio predicho para la tasa de natalidad de 15 a 17 años sería 4.267 para esos estados. Dado que no hay estados con tasa de pobreza = 0, esta interpretación de la intersección no es prácticamente significativa para este ejemplo.
En el gráfico con una línea de regresión presente, también vemos la información que S = 5.55057 y R2 = 53.3%.
¿Qué es regresión en estadistica ejemplos?
Para calcular la regresión estadística, necesita al menos dos variables. En el caso más simple, ambas variables son métricas, pero también existe la opción de calcular la regresión con variables escaladas categóricas u ordinarias. Puede encontrar información útil sobre esto bajo niveles de escala en SPSS. El resultado de la factura le dice cuán fuerte es la conexión y si es estadísticamente significativa, es decir, en contra del azar.
También aprende el tipo y la dirección del contexto: una conexión positiva describe la forma «Cuanto más», una conexión negativa reconoce el signo negativo del coeficiente de regresión. Describe una relación «más menos». Aquí se puede reconocer claramente los paralelos a las correlaciones en SPSS.
Si hay una conexión significativa, puede concluir de la información sobre la variable para formar la otra. Supongamos que sus variables son «sol» y «número de flores en sus girasoles». Basado en la cantidad de horas de sol, desea utilizar el pronóstico del tiempo para calcular cuántas flores se desarrollarán los girasoles.
El número de horas de sol es el predictor en el ejemplo anterior, lo que significa la variable predictiva. A veces también se conoce como regresor. El número de flores es la variable de criterio. Se llama así porque quieres hacer una predicción a través de esta variable.
Con una regresión lineal simple, exactamente dos variables entran en el análisis. Ambos son métricos y la conexión aceptada es lineal. También hay otras formas de regresión estadística, por ejemplo, la regresión múltiple, en las que se registran varios predictores. Esto a menudo tiene sentido, ya que en muchos casos la variable de criterio no se puede predecir bien con una sola variable.
¿Qué hace la regresión en estadística?
El aprendizaje automático requiere grandes cantidades de datos para funcionar correctamente. Es imposible saber a priori qué tamaño debe tener la base de datos para el aprendizaje automático a funcionar correctamente, dependiendo de la complejidad del problema estudiado y la calidad de los datos, pero un orden de magnitud bastante habitual es que, para una regresión o clasificación. Problema basado en datos tabulares, se necesitan diez veces más ejemplos en la base de datos que las variables de las entradas del problema (grados de libertad) [57], [58]. Para cuestiones complejas, es posible que sea más cien a mil veces más ejemplos que grados de libertad. Para la clasificación de imágenes, a partir de cero, generalmente es necesario tener ~ 1000 imágenes por clase, o ~ 100 imágenes por clase si realizamos la transferencia mediante la transferencia de un modelo existente en lugar de cero [59], [60].
La calidad de los datos da como resultado su riqueza y su equilibrio estadístico, su integridad (sin valores faltantes), así como su precisión (incertidumbres débiles).
Puede ser difícil controlar la integridad de los juegos de datos, especialmente en el caso de los datos generados por las redes sociales [61].
La calidad de las «decisiones» tomadas por un algoritmo AA depende no solo de la calidad (por lo tanto, de su homogeneidad, confiabilidad, etc.) de los datos utilizados para la capacitación, sino especialmente en su cantidad. Entonces, para un conjunto de datos sociales recopilados sin especial atención a la representación de las minorías, el AA es estadísticamente injusto frente a ellos. De hecho, la capacidad de tomar decisiones «buenas» depende del tamaño de los datos, pero será proporcionalmente menor para las minorías. Por lo tanto, es aconsejable llevar a cabo el aprendizaje automático con los datos más equilibrados posibles, incluso si significa pasar por un tratamiento previo de los datos para restaurar el equilibrio o mediante una modificación/penalización de la función objetivo.
¿Qué es la regresión lineal en estadistica?
En estadísticas, la regresión lineal es un enfoque lineal para modelar la relación entre una respuesta escalar (etiqueta o variable dependiente) y una o más variables exploratorias (características o respuesta o variables independientes). El caso de una variable explicativa se llama regresión lineal simple. Para más de una variable o respuesta explicativa, el proceso se llama regresión lineal múltiple.
En la regresión lineal, las relaciones se modelan utilizando funciones predictoras lineales cuyos parámetros del modelo desconocido se estiman a partir de los datos. Dichos modelos se llaman modelos lineales.
Más comúnmente, se supone que la media condicional de la respuesta dada los valores de las variables explicativas (respuesta o predictores) es una función afina de esos valores; Con menos frecuencia, se usa la mediana condicional o algún otro cuantil. Como todas las formas de análisis de regresión, la regresión lineal se centra en la distribución de probabilidad condicional de la respuesta dados los valores de los predictores.
El modelo de regresión lineal puede representarse mediante la siguiente ecuación
- Y es el valor predicho
- θ₀ es el término de sesgo.
- θ₁,…, θₙ son los parámetros del modelo
- x₁, x₂,…, xₙ son los valores de la característica.
- θ es el vector de parámetros del modelo, incluido el término de sesgo θ₀
- x es el vector de características con x₀ = 1
- Exogeneidad débil. Esto esencialmente significa que las variables predictoras x pueden tratarse como valores fijos, en lugar de variables aleatorias. Esto significa, por ejemplo, que se supone que las variables predictoras están libres de errores, es decir, no contaminadas con errores de medición.
- Linealidad. Esto significa que la media de la variable de respuesta es una combinación lineal de los parámetros (coeficientes de regresión) y las variables predictoras. La relación entre la respuesta y las variables de características debe ser lineal. La suposición de linealidad se puede probar utilizando gráficos de dispersión. Como se muestra a continuación, la primera figura representa variables relacionadas linealmente en las que las variables en la segunda y tercera cifra son probablemente no lineales. Entonces, la primera cifra dará mejores predicciones usando regresión lineal.
¿Qué es la regresión lineal en Estadistica y para qué sirve?
La parte sistemática del modelo, f (x1, x2,… xp), representa el valor de y esperaríamos ver valores particulares de x1, x2,… xp, si no hubiera un error impredecible: por esta razón es llamado valor predicho. Por lo general, se escribe como (y Hat), y se puede considerar como el valor medio de y dados los predictores: si pudiéramos tomar un gran grupo de personas con valores idénticos de todos los predictores, la media de y en el El grupo podría calcularse sustituyendo los valores de los predictores en F (x1, x2,… xp).
El término β0 se llama intercepción. Si todos los predictores x1, x2,… xp son iguales a cero, entonces serán iguales a β0. En la práctica, esto rara vez sucede: nadie tiene un DMM o un IMC de cero. La intersección es matemáticamente necesaria, pero no es de interés práctico. Probablemente es por esta razón que Desai et al. [1] No dé su valor.
Los otros coeficientes β pueden interpretarse como la diferencia en Y, esperaríamos ver entre dos grupos que diferían en 1 en sus valores medios para la variable predictor correspondiente, pero tenían los mismos valores medios para todas las demás variables. Es tentador pensar en βi como el cambio que esperaría ver en Y si cambiaras Xi por 1, pero este no es necesariamente el caso. Por ejemplo, la ecuación. (1) (ver Apéndice) sugiere que cuando un sujeto envejece por 1 año, su DMO aumentará en 0.002 g/cm2, pero esto solo será cierto si su IMC y la DMO de mano no cambian en ese año. Si la DMM o el IMC manual tienden a cambiar sistemáticamente con la edad, entonces la DMO de los sujetos no típicamente aumentará en 0.002 g/cm2 por año.
¿Por qué se llama regresión lineal?
La regresión lineal es la primera técnica de aprendizaje automático o modelado estadístico, todos aprenden en clases y tiene una aplicación universal en varios campos. Cuando cualquiera, cualquiera quiere describir la relación entre una variable de respuesta continua y una o más continua o categórica independiente o variable de regresor variable , primero hace una regresión con un diagrama de dispersión para una regresión lineal simple y luego con diferentes paquetes estadísticos de regresión lineal múltiple para regresión lineal múltiple. Polinomio o cualquier otra relación de orden superior está ahí. Pero incluso si la curva de diagrama de dispersión no es una línea recta o lineal, todavía usamos regresión lineal para el ajuste de la curva y alguna vez lo has pensado en ello, a veces, hacemos una transformación de variables o agregamos. Términos de orden superior de la variable independiente para definir la funcional relación pero aún así llámalo lineal. ¿Cuál es la explicación de ello?
Entonces, la linealidad tiene básicamente dos explicaciones. Uno es lineal en variable y el otro es lineal en los parámetros. La suposición de linealidad en la regresión lineal significa que el modelo es lineal en parámetros (es decir, coeficientes de variables) y puede o no ser lineal en variables. ??
Es lineal tanto en variable como en el parámetro, ya que tanto el coeficiente «B» como la variable «X» tienen la potencia más alta 1 en la ecuación.
Es lineal en parámetros pero no lineal en variable porque tenemos la potencia más alta de x es 2 aquí
Artículos Relacionados:
- Aprende a realizar regresion lineal multiple en estadistica inferencial con estos sencillos pasos
- ¿Qué es la regresión lineal y cómo se puede utilizar para optimizar su sitio web?
- Regresión lineal: una introducción a los tipos de regresión lineal
- Ejemplos de regresión lineal: cómo aplicar este modelo de machine learning

