
Muchos de los conceptos básicos de líneas se extienden a una regresión lineal simple. En una regresión lineal simple, decimos que nuestra respuesta Yi, donde este es el valor ésimo de nuestra variable de respuesta, tiene una relación lineal con nuestra variable predictor Xi, el valor de nuestra variable predictor. Poniendo esto en forma de línea, esto sería
Nuevamente, nuestra intercepción β0 es el valor que esperamos que nuestra respuesta sea cuando nuestro predictor es igual a cero, aunque este valor puede no tener sentido lógico. Nuestra pendiente β1 es cuánto esperamos que aumente nuestra respuesta si nuestro predictor aumenta en una sola unidad.
Ahora, la forma en que la relación entre nuestro predictor y la respuesta como se describe actualmente dice que nuestros valores de respuesta caen perfectamente en una línea, lo que significa que deberíamos poder predecir perfectamente nuestra respuesta. Mirando la trama de los viejos datos de Geyser Faily en la figura 19.2, este claramente no es el caso y, en general, no lo será. Debido a este hecho, debemos reconocer que hay un error en nuestra respuesta. Es decir, si bien nuestra línea puede hacer un buen trabajo al predecir nuestra respuesta, siempre hay una cierta cantidad de error aleatorio inexplicable. Con esto en mente, necesitamos hacer una adición a la ecuación de nuestra línea para representar este error.
Figura 19.2. Tiempo de erupción y tiempo de espera para el viejo géiser fiel.
¿Cómo se hace la regresión lineal simple?
La regresión lineal simple es una técnica que predice una variable métrica de una relación lineal con otra variable métrica.
Recuerde que las «variables métricas» se refieren a variables medidas a nivel de intervalo o relación. El punto aquí es que los cálculos, la adición y la resta- son significativos en las variables métricas («salario» o «longitud») pero no en variables categóricas («nacionalidad» o «color»).
Una compañía quiere saber
¿Podemos predecir el desempeño laboral de los puntajes de IQ?
El primer paso que deben dar es medir el desempeño (de trabajo) y el coeficiente intelectual en la mayor cantidad de empleados posible. Lo hicieron en 10 empleados y los resultados se muestran a continuación.
Al observar estos datos, parece que los empleados con puntajes de coeficiente intelectual más altos también tienden a tener mejores puntajes de desempeño laboral. Sin embargo, esto es difícil de ver con incluso 10 casos, vaya más solo. La solución a esto es crear un diagrama de dispersión como se muestra a continuación.
Tenga en cuenta que los valores de identificación en nuestros datos muestran qué DOT representa qué empleado. Por ejemplo, el punto más alto (mejor rendimiento) es 1 -kinvin, con un puntaje de rendimiento de 115.
De todos modos, si nos movemos de izquierda a derecha (IQ más bajo a mayor), nuestros puntos tienden a estar más altos (mejor rendimiento). Es decir, nuestro diagrama de dispersión muestra una correlación positiva (Pearson) entre el coeficiente intelectual y el rendimiento.
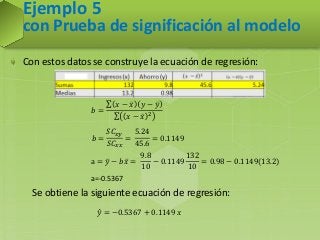
Como se muestra en la figura anterior, la correlación es 0.63. A pesar de nuestro pequeño tamaño de muestra, incluso es estadísticamente significativo porque P <0.05. Hay una fuerte relación lineal entre el coeficiente intelectual y el rendimiento. Pero lo que aún no hemos respondido es: ¿Cómo podemos predecir el rendimiento de IQ? Lo haremos asumiendo que la relación entre ellos es lineal. Ahora la relación exacta requiere solo 2 números, e intercepción y pendiente y regresión los calcularán para nosotros.
Artículos Relacionados:

